Giọng nói tổng hợp có lịch sử dài hơn nhiều người nghĩ. Từ thế kỷ 18 đã có những cỗ máy cơ học bắt chước phổi, thanh quản và miệng người; đến năm 1939, máy Voder của Bell Labs trình diễn tại Hội chợ Thế giới New York là lần đầu một thiết bị điện tử "nói" thành câu trước công chúng. Sau đó, máy tính lần lượt dùng ba cách: dựng giọng từ công thức âm học, ghép các mẩu giọng thật, và từ giữa thập niên 2010 là học từ rất nhiều giờ ghi âm để tạo giọng gần như người thật.
Những cỗ máy nói cơ học thế kỷ 18–19
Ý tưởng làm máy biết nói ra đời rất sớm, gắn với câu hỏi: con người tạo ra nguyên âm bằng cách nào? Năm 1779, nhà khoa học Christian Kratzenstein làm ra bộ ống cộng hưởng có hình dạng khác nhau, mỗi ống thổi qua lưỡi gà cho ra một nguyên âm, và nhờ đó được Viện Hàn lâm Khoa học Sankt-Peterburg trao giải.
Cùng thời, nhà phát minh người Hungary Wolfgang von Kempelen chế tạo một máy nói gồm ống bễ đóng vai phổi, một lưỡi gà rung thay dây thanh, và một "khoang miệng" bằng cao su mà người điều khiển bóp nắn bằng tay. Năm 1791, ông xuất bản một cuốn sách mô tả cỗ máy và những gì ông hiểu về cơ chế lời nói. Máy nói được một số từ và câu ngắn, dù nghe khá khó.
Giữa thế kỷ 19, Joseph Faber ở Vienna chế tạo cỗ máy có bàn phím mang tên Euphonia, có mặt người giả bằng sáp và từng được đem đi trình diễn ở nhiều thành phố, trong đó có London năm 1846. Khán giả khi ấy vừa tò mò vừa thấy rờn rợn trước giọng nói đều đều phát ra từ cái đầu giả.
Điều đáng quý ở những cỗ máy này là chúng đi đúng hướng mà khoa học ngữ âm sau này xác nhận: có một nguồn âm (lưỡi gà thay dây thanh) và một bộ lọc (khoang miệng đổi hình dạng). Mô hình nguồn – bộ lọc ấy vẫn là nền tảng của nhiều kỹ thuật tổng hợp giọng sau này.
Voder 1939: giọng nói điện tử đầu tiên trước công chúng
Từ vocoder đến Voder
Những năm 1930, kỹ sư Homer Dudley ở Bell Labs nghiên cứu cách nén giọng nói để truyền qua đường dây cho tiết kiệm. Ông phân tích giọng thành vài dải tần và thông tin "có rung dây thanh hay không", rồi dựng lại ở đầu kia. Thiết bị này gọi là vocoder. Từ đó nảy ra câu hỏi: nếu dựng lại được, liệu có thể tạo giọng mà không cần người nói thật? Câu trả lời là Voder.
Cỗ máy cần người "chơi" như chơi đàn
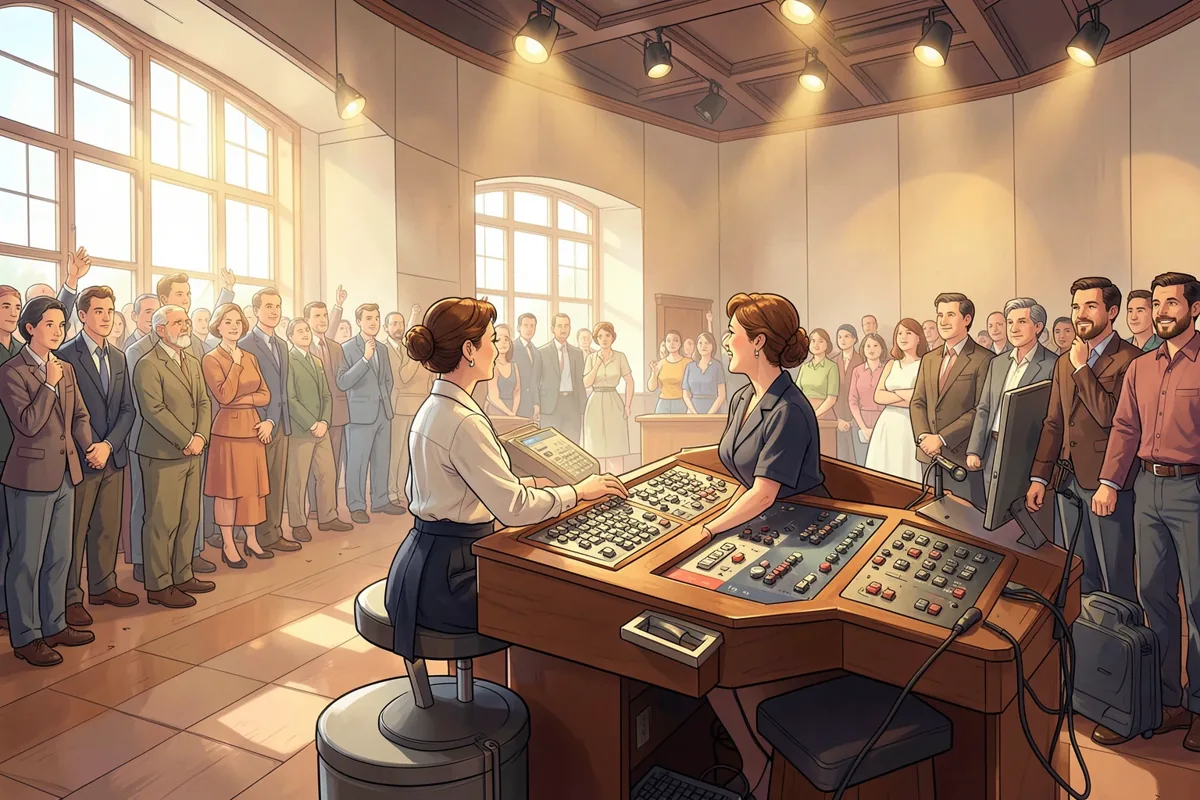
Voder không tự đọc chữ. Nó là một bàn điều khiển có phím bấm và bàn đạp chân. Người vận hành dùng các ngón tay mở đóng mười dải tần để tạo ra âm sắc của nguyên âm, phụ âm; một phím riêng chọn tiếng rung (giống dây thanh) hay tiếng xì (giống hơi gió); bàn đạp chân điều chỉnh cao độ để câu nói có lên xuống. Điều khiển được nó khó như học một nhạc cụ: các nữ điều khiển viên được đào tạo trong nhiều tháng, khoảng một năm, mới cho máy nói trôi chảy trước khán giả.
Hội chợ Thế giới New York 1939
Tại Hội chợ Thế giới New York năm 1939, khán giả xếp hàng xem Voder trả lời câu hỏi, nói những câu chào, thậm chí đổi giọng thành giọng đàn ông, đàn bà, trẻ con chỉ bằng chỉnh bàn đạp. Giọng máy rè và đều đều, nhưng nghe hiểu được. Đó là khoảnh khắc lần đầu đông đảo công chúng nghe một thiết bị điện tử tạo ra lời nói mà không có ai nói vào micro.
Dòng thời gian máy biết nói
| Mốc | Sự kiện | Cách tạo giọng |
|---|---|---|
| 1779 | Kratzenstein làm bộ ống phát nguyên âm | Cơ học: ống cộng hưởng |
| 1791 | Von Kempelen công bố sách về máy nói | Cơ học: bễ, lưỡi gà, miệng cao su |
| Thập niên 1840 | Euphonia của Joseph Faber đi trình diễn | Cơ học có bàn phím |
| 1939 | Voder của Homer Dudley tại Hội chợ Thế giới New York | Điện tử, điều khiển bằng tay |
| 1961 | Máy tính ở Bell Labs "hát" bài Daisy Bell | Máy tính, tổng hợp theo mô hình ống thanh âm |
| Thập niên 1970–1980 | Máy đọc chữ cho người khiếm thị, thiết bị học đánh vần biết nói | Tổng hợp formant theo quy tắc |
| Giữa thập niên 1980 | Nhà vật lý Stephen Hawking bắt đầu dùng giọng máy | Tổng hợp formant |
| Thập niên 1990–2000 | Hệ thống tổng đài, chỉ đường dùng giọng ghép | Ghép các mẩu giọng thật đã ghi |
| Từ khoảng 2016 | Giọng tổng hợp bằng mạng nơ-ron nghe gần như người thật | Học từ nhiều giờ ghi âm |
Ba cách máy tính tạo ra giọng nói
Tổng hợp formant: dựng giọng từ công thức
Cách đầu tiên giống hậu duệ của Voder: chương trình tạo một nguồn âm giả lập dây thanh, rồi cho đi qua các bộ lọc mô phỏng formant của từng nguyên âm, phụ âm. Mọi thứ được điều khiển bằng quy tắc. Ưu điểm là gọn nhẹ, đọc nhanh, rõ chữ ở tốc độ cao — người khiếm thị dùng máy đọc màn hình rất quen kiểu giọng này. Nhược điểm là nghe "máy" rõ rệt, đều đều và lạnh.
Giọng của Stephen Hawking là ví dụ nổi tiếng. Ông mất khả năng nói sau một ca mổ năm 1985 và bắt đầu dùng một bộ tổng hợp giọng nói ít lâu sau đó. Về sau dù có những giọng tự nhiên hơn, ông vẫn giữ giọng cũ vì xem đó là giọng của mình.
Tổng hợp ghép nối: cắt dán giọng người thật
Cách thứ hai thu âm một người đọc hàng giờ văn bản, cắt thành những mẩu nhỏ (âm vị, âm tiết, nửa âm tiết), rồi khi cần đọc câu mới thì chọn và ghép các mẩu phù hợp. Giọng nghe giống người thật hơn hẳn, nhưng chỗ nối hay lộ, ngữ điệu câu dài có lúc gãy. Những thông báo ở nhà ga, sân bay, tổng đài trong thập niên 1990–2000 thường dùng cách này hoặc ghép từ những câu thu sẵn.
Tổng hợp bằng mạng nơ-ron: học cách nói
Cách thứ ba cho máy học từ rất nhiều giờ ghi âm kèm văn bản. Máy không ghép mẩu có sẵn mà tự tạo ra sóng âm mới, học được cả nhịp ngắt, chỗ lấy hơi, cách nhấn. Từ khoảng giữa thập niên 2010, giọng tổng hợp kiểu này đã đủ tự nhiên để nhiều người nghe khó phân biệt với giọng thật trong các câu ngắn.
Làm máy nói tiếng Việt: thanh điệu là thử thách lớn
Với tiếng Việt, máy không chỉ phải đọc đúng phụ âm, nguyên âm mà còn phải đúng sáu thanh, đúng cả chỗ thắt họng của thanh ngã, thanh nặng. Những giọng đọc tiếng Việt đời đầu hay bị chê "lơ lớ", đọc "đã" thành "đá", ngắt câu sai chỗ, đọc số và chữ viết tắt lộn xộn. Các giọng đọc tiếng Việt đời mới đã tốt hơn rất nhiều, có cả giọng Bắc, giọng Nam, nhưng vẫn hay vấp với tên riêng, từ mượn, và cách đọc địa danh mới sau đợt sắp xếp tỉnh thành năm 2025.
Máy biết nói giúp ai
- Người khiếm thị: máy đọc màn hình đọc to tin nhắn, sách, trang web — một cánh cửa lớn để học tập và làm việc.
- Người mất giọng nói do bệnh hay tai nạn: thiết bị giao tiếp hỗ trợ cho phép gõ chữ để máy nói thay.
- Người có nguy cơ mất giọng: có dịch vụ "lưu giọng" — thu âm trước một số câu để sau này máy nói bằng giọng gần với giọng của chính họ.
- Người học ngoại ngữ, người khó đọc chữ, người lớn tuổi mắt kém: nghe đọc to thay vì đọc.
Mặt trái và vài điều nên nhớ
Khi máy có thể tạo giọng giống hệt một người từ vài đoạn ghi âm ngắn, giọng nói không còn là bằng chứng chắc chắn rằng đầu dây bên kia đúng là người mình quen. Các vụ lừa đảo giả giọng người thân để đòi chuyển tiền đã xuất hiện ở nhiều nước, trong đó có Việt Nam. Nguyên tắc tự vệ đơn giản: không chuyển tiền chỉ vì nghe giọng quen; gọi lại vào số quen để xác nhận; cẩn thận khi đăng nhiều video có giọng nói rõ của trẻ em và người già lên mạng công khai.
Một câu hỏi khác đang được bàn: có nên luôn cho người nghe biết họ đang nghe giọng máy? Nhiều nơi đã bắt đầu đặt quy định hoặc nguyên tắc về chuyện này. Với người dùng bình thường, thói quen tốt là hỏi thẳng khi nghi ngờ, và không coi giọng nói là thứ thay được giấy tờ hay xác minh trực tiếp.
Câu hỏi thường gặp
Voder là gì?
Voder là máy tạo giọng nói điện tử do Homer Dudley ở Bell Labs phát triển, trình diễn tại Hội chợ Thế giới New York năm 1939. Người vận hành dùng phím bấm và bàn đạp để tạo nguyên âm, phụ âm và cao độ, giống như chơi một nhạc cụ.
Máy biết nói đầu tiên xuất hiện khi nào?
Từ cuối thế kỷ 18 đã có máy nói cơ học, như máy của Wolfgang von Kempelen được ông mô tả trong sách năm 1791. Voder năm 1939 là máy điện tử đầu tiên nói thành câu trước đông đảo công chúng.
Giọng nói tổng hợp hoạt động thế nào?
Có ba cách chính: dựng giọng bằng công thức mô phỏng dây thanh và khoang miệng, ghép các mẩu giọng người thật đã thu sẵn, và cho mạng nơ-ron học từ nhiều giờ ghi âm để tự tạo sóng âm mới. Cách sau cùng cho giọng tự nhiên nhất.
Vì sao giọng máy đọc tiếng Việt hay bị lơ lớ?
Tiếng Việt có sáu thanh, mỗi thanh khác nhau cả ở cao độ, độ dài và chỗ thắt họng. Máy đọc sai thanh hay ngắt câu sai là nghe lơ lớ ngay; tên riêng, từ mượn và số cũng là chỗ máy hay vấp.
Giọng của Stephen Hawking là giọng gì?
Đó là giọng tổng hợp theo kiểu formant mà ông dùng sau khi mất khả năng nói từ giữa thập niên 1980. Dù có giọng tự nhiên hơn về sau, ông vẫn giữ giọng ấy vì coi đó là giọng của mình.